


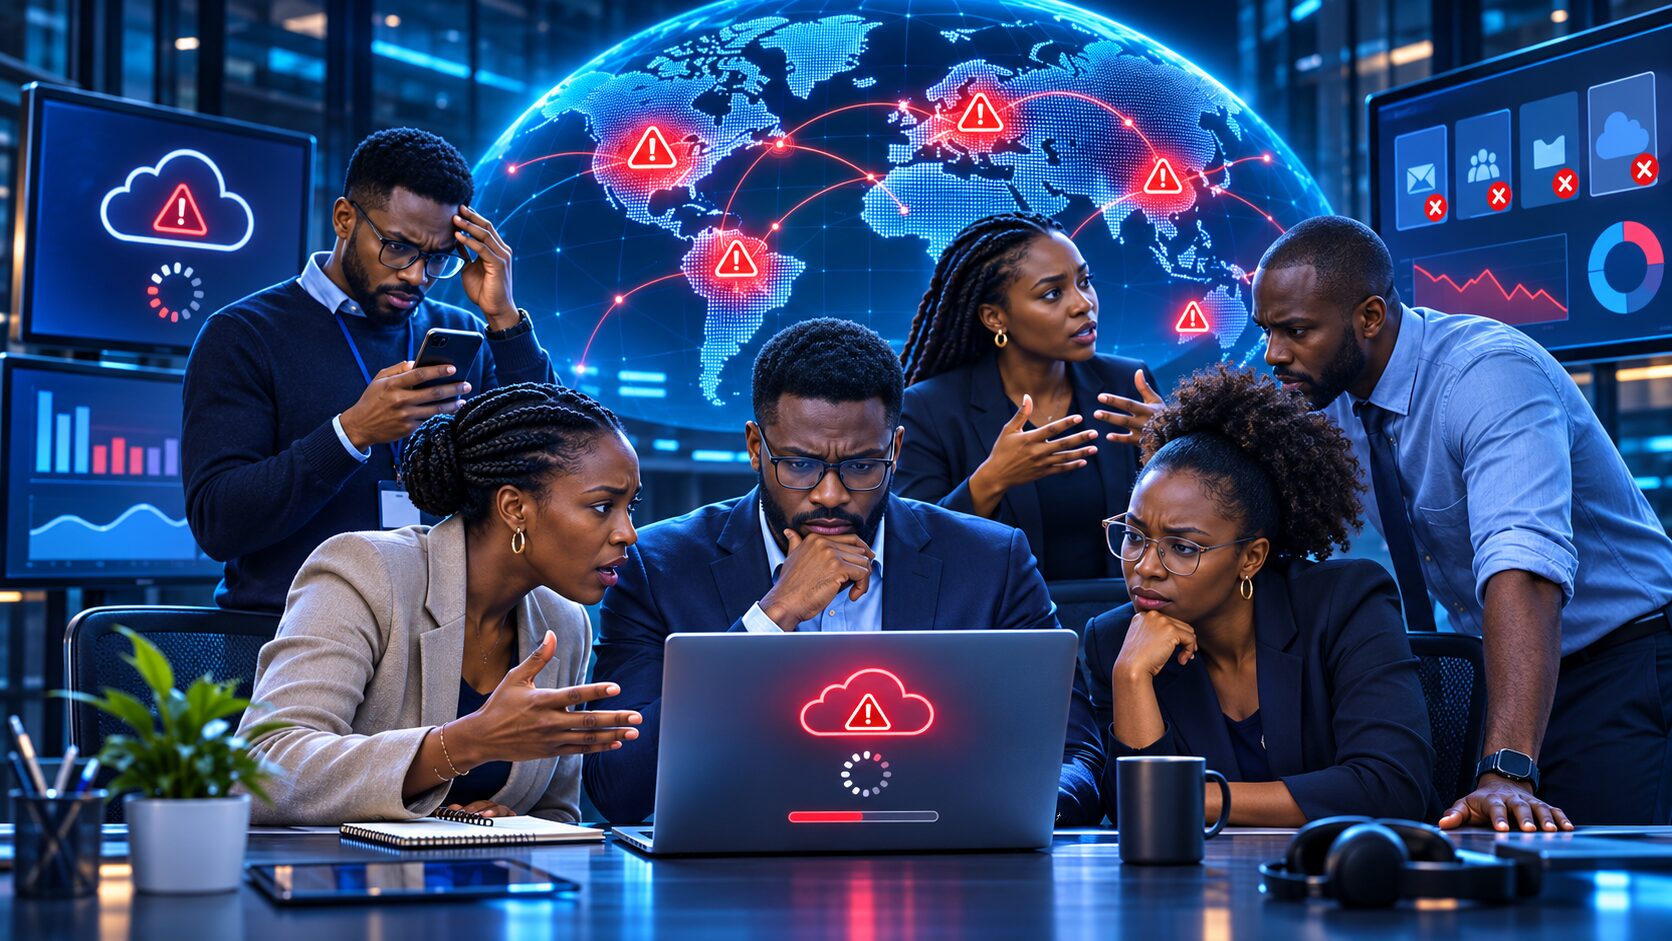
Outlook, Teams, SharePoint, Copilot : une panne d’une ampleur exceptionnelle a ébranlé l’écosystème numérique de Microsoft, perturbant pendant plus de vingt-quatre heures les communications d’entreprises, d’administrations et d’institutions à travers le monde. Désormais rétablis, les services du géant américain laissent derrière eux une interrogation essentielle : notre dépendance aux grandes infrastructures numériques est-elle devenue un risque pour la continuité des activités ?
Le jeudi 12 novembre 2026, ce qui semblait initialement n’être qu’une difficulté d’accès à certaines messageries professionnelles s’est progressivement transformé en une perturbation informatique d’envergure mondiale.
Des utilisateurs ont soudainement été incapables de consulter leurs courriels Outlook, d’envoyer des messages ou de synchroniser leurs agendas. D’autres ont rencontré des difficultés avec Microsoft Teams, SharePoint, Copilot et plusieurs outils professionnels intégrés à Microsoft 365.
En quelques heures, des entreprises, des administrations publiques, des établissements de santé et des institutions financières se sont retrouvés privés de certaines fonctionnalités numériques indispensables à leurs activités quotidiennes.
Selon les données communiquées par Downdetector et rapportées par Reuters le 14 novembre, plus de 7,4 millions de signalements de dysfonctionnement ont été enregistrés à travers le monde pendant cet épisode. Ce chiffre correspond au nombre de signalements, et non au nombre exact d’utilisateurs touchés, lequel demeure inconnu.
Des perturbations ont été rapportées dans plus de 70 pays et territoires.
Après une restauration progressive engagée dès le vendredi, Microsoft a confirmé le samedi 14 novembre le rétablissement de ses services pour les derniers clients et régions encore affectés.
L’incident figure parmi les interruptions les plus marquantes de l’histoire récente de Microsoft 365, tant par son étendue géographique que par les activités professionnelles qu’il a perturbées.
Pour comprendre l’ampleur de cette défaillance, il convient de distinguer les applications que les utilisateurs manipulent quotidiennement de l’infrastructure informatique qui leur permet de fonctionner.
Outlook constitue l’interface de messagerie, tandis qu’Exchange Online assure, dans les environnements professionnels de Microsoft 365, des fonctions essentielles telles que la gestion des boîtes aux lettres, l’acheminement des courriels et la synchronisation des calendriers.
D’autres applications de Microsoft dépendent également, pour certaines de leurs fonctionnalités, de cette infrastructure commune.
Ainsi, lorsqu’Exchange Online rencontre une difficulté majeure, les conséquences ne se limitent pas nécessairement à Outlook.
Dans Teams, par exemple, la consultation du calendrier, la programmation de réunions ou la gestion des invitations peuvent être perturbées. Certaines fonctionnalités de SharePoint et de Copilot peuvent également devenir indisponibles lorsqu’elles ont besoin d’accéder aux données hébergées par Exchange Online.
Il importe toutefois de préciser que tous les composants de ces plateformes n’ont pas cessé de fonctionner simultanément. Microsoft a confirmé que plusieurs fonctions essentielles de Teams, notamment certains appels et échanges de messages, sont restées opérationnelles.
Cette distinction révèle une caractéristique fondamentale des architectures numériques modernes : plusieurs applications peuvent paraître indépendantes à l’utilisateur tout en reposant sur des services techniques communs.
La défaillance d’un composant central est alors susceptible de provoquer des perturbations en cascade.
Les premières analyses de Microsoft avaient mis en évidence une surcharge de plusieurs serveurs répartis dans différentes régions.
Mais cette surcharge n’était pas liée à une augmentation inhabituelle du nombre d’utilisateurs.
L’entreprise a constaté qu’une partie de ses serveurs devenait subitement indisponible, contraignant les machines encore fonctionnelles à absorber une charge supplémentaire.
Les équipes techniques ont tenté de redémarrer les serveurs concernés et de redistribuer les connexions vers d’autres infrastructures. Certaines machines redevenaient néanmoins défaillantes lorsqu’elles recommençaient à recevoir du trafic.
Les investigations ont finalement permis d’identifier un mécanisme plus précis.
Selon les premières conclusions techniques publiées par Microsoft, l’incident trouve son origine dans une anomalie introduite lors d’une précédente augmentation de capacité de son réseau. Un changement ultérieur de configuration ou de routage a révélé cette défaillance jusque-là latente.
Plus précisément, le problème concernait des systèmes chargés d’établir les connexions sécurisées vers les services.
Ces systèmes n’arrivaient plus à traiter correctement certaines nouvelles demandes de connexion. Les requêtes s’accumulaient alors dans des files d’attente, jusqu’à épuiser la capacité de traitement des serveurs concernés.
Pour comprendre ce phénomène, imaginons un centre administratif disposant de plusieurs guichets. Si certains cessent brusquement de recevoir les visiteurs, les autres doivent accueillir une foule croissante. Lorsque leur capacité maximale est atteinte, l’ensemble du service finit par se congestionner.
C’est, de manière simplifiée, le type d’enchaînement observé dans cette panne.
Cette explication demeure préliminaire : Microsoft a annoncé la publication d’un rapport technique post-incident destiné à préciser les mécanismes exacts de la défaillance et les mesures destinées à prévenir sa répétition.
Microsoft a expressément écarté cette hypothèse dans ses communications.
Selon l’entreprise, les éléments recueillis ne montrent pas que la panne ait été provoquée par une activité malveillante. Elle a également précisé que l’incident n’était pas lié à des agents d’intelligence artificielle.
À ce stade, les informations officielles orientent donc vers une défaillance technique interne, et non vers une attaque informatique.
L’ampleur de l’incident ne se mesure pas seulement au nombre de connexions interrompues.
Ses conséquences ont dépassé les simples difficultés de messagerie.
Au Royaume-Uni, les perturbations ont affecté certains services de police et de santé. Des difficultés ont notamment été signalées dans la transmission de communications et de prescriptions médicales. Une procédure judiciaire à Manchester a également été interrompue.
Au Japon et à Singapour, plusieurs administrations ont fait état de problèmes affectant leurs communications électroniques.
Dans le secteur financier, des établissements et des entreprises ont dû recourir à des procédures alternatives pour assurer la continuité de certaines opérations. Reuters rapporte notamment qu’une entreprise financière taïwanaise a utilisé le télécopieur pour confirmer des transactions.
Des compagnies aériennes indiennes, dont Air India et IndiGo, ont également signalé des perturbations touchant leurs services de communication par courriel.
Ces situations illustrent une réalité souvent sous-estimée : la disponibilité d’une messagerie professionnelle peut conditionner des activités dont les conséquences dépassent largement le domaine informatique.
Un courriel inaccessible peut retarder une confirmation financière, une communication administrative, une décision opérationnelle ou une prestation de service.
L’incident a mis en lumière une autre dimension de la dépendance numérique : l’interconnexion croissante entre les services infonuagiques et les assistants d’intelligence artificielle.
Microsoft Copilot, intégré à l’environnement Microsoft 365, a rencontré des difficultés pour accéder à certaines informations professionnelles.
Mais les répercussions ne se sont pas limitées aux produits de Microsoft.
OpenAI et Anthropic ont également signalé des problèmes concernant les connexions de ChatGPT et Claude aux services de Microsoft 365. Ces difficultés ont ensuite été résolues.
Il ne s’agissait pas d’une indisponibilité générale de ChatGPT ou de Claude, mais de perturbations affectant leurs capacités d’interaction avec les services Microsoft concernés.
Cette distinction est importante.
Lorsqu’un assistant d’intelligence artificielle est autorisé à consulter une boîte de réception, rechercher un document ou examiner un calendrier professionnel, il dépend de la disponibilité des systèmes qui hébergent ces informations.
Même si son modèle d’intelligence artificielle fonctionne normalement, certaines tâches deviennent impossibles lorsque les services externes nécessaires sont indisponibles.
À mesure que les entreprises confient davantage de tâches à des assistants et agents intelligents, cette dépendance aux plateformes tierces devient un enjeu majeur de fiabilité opérationnelle.
Une infrastructure informatique mondiale ne peut pas toujours être remise en service par un simple redémarrage.
Dans le cas de Microsoft 365, les ingénieurs ont dû intervenir sur plusieurs composantes de l’architecture réseau, réorienter du trafic, restaurer de la capacité et vérifier la stabilité des serveurs.
Le problème était particulièrement délicat puisque certains systèmes redevenaient instables après leur remise en fonctionnement.
Une restauration trop rapide aurait donc pu provoquer de nouvelles défaillances.
Microsoft a privilégié un retour progressif, en contrôlant la stabilité des différents environnements avant de réintroduire davantage de connexions.
Cette stratégie explique en partie pourquoi certains utilisateurs ont pu retrouver l’accès à leur messagerie alors que l’envoi ou la réception des courriels demeurait lent.
Un autre phénomène a compliqué la reprise : l’accumulation des messages en attente de traitement.
Lorsqu’un serveur de messagerie ne peut pas immédiatement transmettre un courriel, celui-ci peut être temporairement conservé dans une file d’attente pour faire l’objet de nouvelles tentatives de livraison.
Durant l’incident, Microsoft a prolongé à 48 heures la fenêtre d’expiration de certains courriels afin de réduire le risque que des messages retardés soient abandonnés prématurément.
Cette mesure visait à faciliter leur transmission après le rétablissement du service.
Elle ne constitue cependant pas une garantie absolue que tous les messages aient été distribués.
Les entreprises ayant échangé des informations importantes pendant la panne ont donc intérêt à vérifier les confirmations de réception et, lorsque cela s’avère nécessaire, les journaux de suivi des messages.
L’informatique en nuage, ou cloud computing, permet aux entreprises d’utiliser des applications, de stocker des données et d’exploiter des ressources informatiques sans devoir nécessairement héberger elles-mêmes l’ensemble de leurs serveurs.
Ce modèle présente des avantages considérables : mutualisation des infrastructures, accessibilité à distance, capacité d’évolution, maintenance centralisée et réduction de certaines contraintes matérielles.
Cependant, l’incident de Microsoft 365 rappelle qu’une infrastructure externalisée n’est pas une infrastructure infaillible.
L’utilisation d’un fournisseur mondial peut accroître la résilience face à certaines pannes locales, sans éliminer les risques de défaillances communes à plusieurs régions ou services.
Le véritable enjeu n’est donc pas d’opposer systématiquement le cloud aux infrastructures locales, mais de déterminer comment une organisation peut continuer à exercer ses activités essentielles lorsqu’un fournisseur devient temporairement inaccessible.
Cette question concerne particulièrement les entreprises qui centralisent leur messagerie, leur calendrier, leur documentation, leur collaboration interne et leurs processus automatisés auprès d’un seul prestataire.
Une telle concentration peut simplifier les opérations quotidiennes, mais elle crée également des dépendances dont les conséquences doivent être anticipées.
La panne mondiale de Microsoft 365 constitue un rappel concret de l’importance des plans de continuité informatique.
Plusieurs mesures peuvent contribuer à limiter les conséquences d’un incident similaire.
Prévoir des moyens de communication indépendants. Une entreprise devrait pouvoir joindre ses collaborateurs et ses partenaires même lorsque sa messagerie principale est indisponible. Cela peut nécessiter des canaux de secours reposant sur une infrastructure distincte.
Identifier les dépendances techniques critiques. Il est essentiel de savoir quelles applications, automatisations et procédures deviennent inutilisables lorsque certains services cloud cessent de répondre.
Préparer des procédures de fonctionnement dégradé. Les équipes doivent savoir comment traiter temporairement les opérations prioritaires sans leurs outils habituels.
Surveiller l’état des services. Les administrateurs peuvent consulter les tableaux de santé de Microsoft 365 et les avis d’incident afin de distinguer une panne du fournisseur d’un problème propre à leur organisation.
Tester régulièrement les dispositifs de continuité. Un plan de secours n’offre une protection réelle que s’il peut être exécuté efficacement au moment où les systèmes principaux deviennent indisponibles.
Les entreprises doivent également comprendre que la sauvegarde des données et la disponibilité des services constituent deux enjeux différents.
Posséder une copie de ses informations ne garantit pas nécessairement de pouvoir continuer à travailler lorsque l’application qui permet de les exploiter est inaccessible.
Une stratégie de résilience doit donc prendre en considération les données, les applications, les accès, les communications et les procédures humaines.
Au-delà des difficultés rencontrées par Microsoft, cet épisode soulève une interrogation plus profonde sur l’organisation de l’économie numérique.
Les grandes plateformes technologiques occupent aujourd’hui une place structurante dans les communications professionnelles, les services publics, les échanges commerciaux et, désormais, les usages de l’intelligence artificielle.
Cette concentration procure des avantages considérables en matière d’intégration et de mutualisation des ressources.
Mais elle signifie également qu’un incident technique survenu au sein d’un fournisseur peut produire des effets simultanés dans des organisations qui n’entretiennent pourtant aucun lien direct entre elles.
Les perturbations du 12 au 14 novembre montrent qu’une défaillance informatique ne reste pas nécessairement confinée à un centre de données ou à une application particulière.
Elle peut se propager, par l’intermédiaire des dépendances techniques, à une multitude de secteurs d’activité.
Pour les responsables informatiques, les dirigeants d’entreprise et les autorités publiques, la question de la souveraineté et de la résilience numériques prend ainsi une dimension particulièrement concrète.
Il ne suffit plus de demander si une plateforme offre de bonnes performances lorsqu’elle fonctionne normalement.
Il faut également se demander ce qu’il advient de l’organisation lorsqu’elle cesse de fonctionner.
Microsoft a finalement réussi à restaurer ses services, mettant un terme à une panne mondiale qui aura profondément perturbé les activités de nombreuses organisations.
Mais cet incident laisse une leçon importante.
À l’heure où les entreprises accélèrent leur transformation numérique et intègrent toujours davantage d’intelligence artificielle à leurs processus, leur efficacité dépend d’un nombre croissant de systèmes interconnectés.
La performance de ces technologies représente un progrès incontestable. Leur disponibilité, en revanche, ne doit jamais être considérée comme acquise.
La véritable maturité numérique d’une organisation ne se mesure pas uniquement à la sophistication des outils qu’elle utilise, mais aussi à sa capacité de poursuivre ses activités lorsque ces outils deviennent indisponibles.
La panne de Microsoft 365 rappelle ainsi une exigence fondamentale : dans une économie toujours plus connectée, la continuité des services doit être pensée avec autant de rigueur que leur innovation.
Sources et références
- Microsoft, bulletins techniques MO1550821 et EX1550543, communications des 12 au 14 novembre 2026, consultables dans les rapports d’incident Microsoft 365 relayés par l’Université de Pennsylvanie.
- Reuters, 14 novembre 2026, Microsoft restores service to Outlook and Teams after global outage.
- Associated Press, 14 novembre 2026, Microsoft says services fully restored after hourslong global outage.
- Lawrence Abrams, BleepingComputer, 12–13 novembre 2026, Massive Microsoft 365 outage disrupts Outlook, Teams, Copilot worldwide.
© TekTek — Actualité, analyse et décryptage des technologies numériques.


